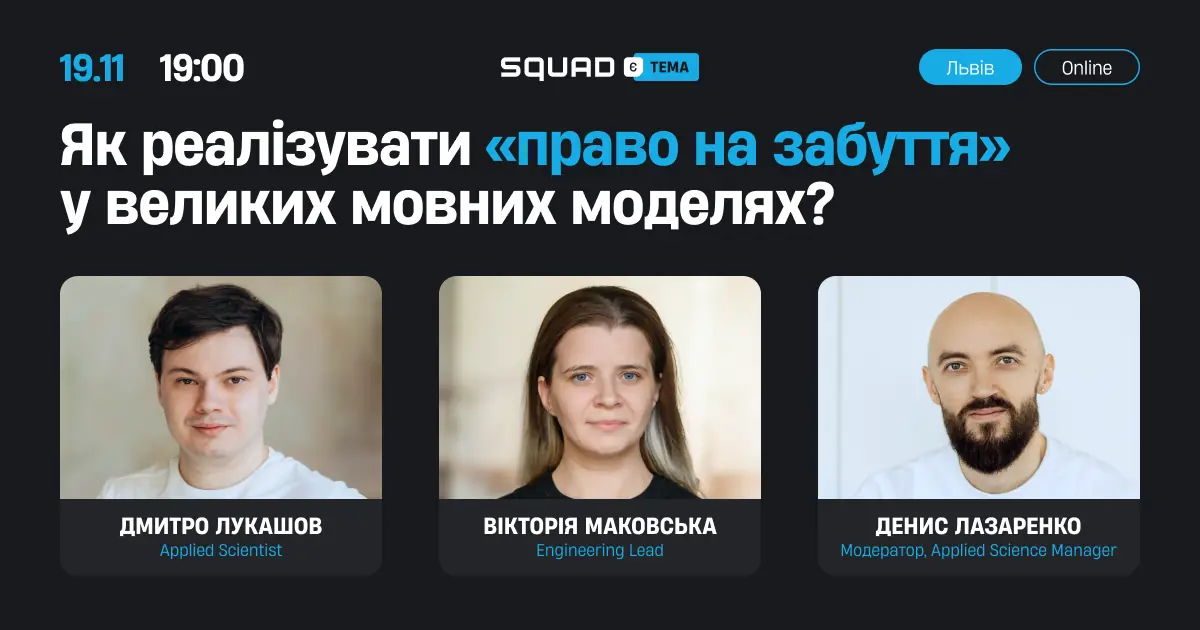
Мітап для тих, хто досліджує, дотреновує або впроваджує LLM: як відрізнити забуття від приховування, як перевірити результат і коли unlearning варто застосовувати, попри його обмеження.
Великі мовні моделі можуть запамʼятовувати й відтворювати персональні дані, конфіденційну інформацію та фрагменти контенту, захищеного авторським правом. Просто видаляти документи із навчального набору не є рішенням цієї проблеми, тому що це негативно впливає на її вміння.
19 листопада у Львові АІ-фахівці SQUAD розберуть, як LLM unlearning намагається розвʼязати цю проблему – і чому реалізувати «право бути забутим» у мовних моделях складніше, ніж здається.
Чекаємо на вас для цікавих дискусій та теплого нетворкінгу!
Реєстрація на подію обовʼязкова.
Мітап для тих, хто досліджує, дотреновує або впроваджує LLM: як відрізнити забуття від приховування, як перевірити результат і коли unlearning варто застосовувати, попри його обмеження. Великі мовні моделі можуть запамʼятовувати й відтворювати персональні дані, конфіденційну інформацію та фрагменти контенту, захищеного авторським правом. Просто видаляти документи із навчального набору не є рішенням цієї проблеми, тому що […]
https://itcluster.lviv.ua/wp-content/uploads/2026/11/squad_e-tema_1200x630_ua.png


